Distributed lock với Redis: những điểm cần cân nhắc
Mục lục
Dài quá lười đọc: Redis là hệ thống AP, không phải CP, nên không đảm bảo strong consistency. Với những trường hợp có nhiều thao tác đồng thời, bạn cần lường trước khả năng xảy ra data race khi dùng Redis. Nếu cần đảm bảo chặt chẽ, hãy cân nhắc hệ thống có strong consistency như etcd hoặc ZooKeeper.
Lock trên một Redis instance duy nhất⌗
Ở bài trước, chúng ta đã tìm hiểu cách cài đặt distributed lock bằng một Redis instance. Bài đó đã trả lời câu hỏi nếu client crash thì sao?, nhưng còn bỏ ngỏ một câu hỏi quan trọng: nếu chính Redis gặp sự cố thì sao?
Bài này sẽ tìm hiểu câu hỏi ấy, và vì sao câu trả lời có nhiều điều cần cân nhắc hơn bạn tưởng.
Redis là một hệ thống AP⌗
Nếu chưa rõ hệ thống AP có nghĩa gì trong định lý CAP, bạn có thể đọc bài này của mình.
Hệ thống AP ưu tiên tính sẵn sàng hơn tính nhất quán của dữ liệu giữa các node. Khi gặp sự cố như network partition hoặc node crash, hệ thống vẫn hoạt động nhưng có thể trả về dữ liệu cũ hoặc không nhất quán.
Redis mặc định dùng replication bất đồng bộ trong kiến trúc primary-replica. Một lệnh ghi đã được primary xác nhận chưa chắc đã được sao chép sang replica trước khi client nhận phản hồi.
Với distributed lock, đây là một vấn đề. Nếu primary crash sau khi xác nhận client đã lấy được lock nhưng trước khi sao chép dữ liệu, replica được nâng lên làm primary sẽ không có lock ấy. Client khác có thể lấy cùng lock, phá vỡ tính loại trừ tương hỗ. Redis có cơ chế đồng bộ lại dữ liệu sau failover, nhưng trong khoảng thời gian đó, primary mới vẫn có thể hoạt động với trạng thái cũ.

Vấn đề split-brain⌗
Ngay cả khi dùng nhiều Redis instance cùng thuật toán Redlock, vẫn còn một vấn đề căn bản: split-brain.
Giả sử client A lấy lock và bắt đầu xử lý rồi bị tạm dừng. Nguyên nhân có thể là garbage collection (GC) kéo dài, máy ảo bị tạm dừng hoặc độ trễ mạng. Trong khoảng đó, lock không được gia hạn nên TTL hết hạn. Client B lấy cùng lock và bắt đầu xử lý tài nguyên chung. Khi A chạy tiếp, nó không biết lock đã hết hạn và vẫn thao tác như thể mình có quyền truy cập độc quyền.
Lúc này, cả hai client cùng sửa một tài nguyên. Đây là tình huống split-brain điển hình: hai process đều tưởng chỉ mình được phép truy cập, nhưng thực tế không bên nào có quyền độc quyền ấy.
Martin Kleppmann phân tích kỹ vấn đề này trong bài How to do distributed locking. Nhận định chính của ông là Redlock dựa trên những giả định nguy hiểm về thời gian: độ trễ mạng có giới hạn, thời gian process bị dừng có giới hạn và sai lệch đồng hồ có giới hạn. Hệ thống phân tán thường xuyên không đáp ứng được những giả định ấy.
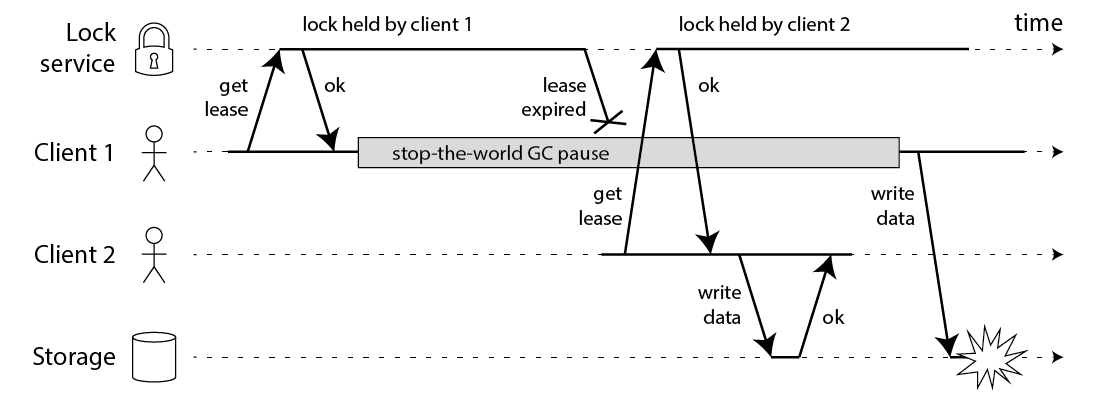
Nguồn ảnh: Martin Kleppmann
Kleppmann đề xuất fencing token: một số tăng đơn điệu được cấp mỗi lần lấy lock. Hệ thống lưu trữ được bảo vệ phải từ chối thao tác có token nhỏ hơn token lớn nhất đã chấp nhận. Nhờ đó, client bị tạm dừng có chạy tiếp muộn thì thao tác dùng token cũ cũng bị từ chối. Khác với ownership token ngẫu nhiên ở bài trước, fencing token xác định thứ tự các lần lấy lock và cần được tài nguyên được bảo vệ kiểm tra.
Lưu ý: Một số tăng đơn điệu chỉ tăng, không giảm. Mỗi giá trị mới lớn hơn mọi giá trị trước đó, chẳng hạn 1, 2, 3, … Tính chất này giúp hệ thống lưu trữ xác định thứ tự của fencing token: token lớn hơn tương ứng với lần lấy lock gần đây hơn.
Một số cơ chế xác định thứ tự đơn điệu trong hệ thống phân tán:
- Lamport clock: đồng hồ logic đơn giản, tăng sau mỗi sự kiện.
- Vector clock: cơ chế mở rộng để theo dõi quan hệ nhân quả giữa nhiều node.
- zxid của ZooKeeper: transaction ID 64-bit, tăng sau mỗi lần trạng thái thay đổi.
- Database sequence, như
SERIALcủa PostgreSQL hoặcAUTO_INCREMENTcủa MySQL: bộ đếm tập trung đảm bảo tính duy nhất và thứ tự.
Redis có lệnh tăng bộ đếm là INCR. Khó khăn nằm ở việc đảm bảo fencing token vẫn tăng qua các sự cố. Với replication bất đồng bộ, primary có thể xác nhận đã tăng bộ đếm trước khi replica nhận được thay đổi. Khi failover, lần tăng ấy có thể bị mất và giá trị cũ có thể được dùng lại. Ownership token ngẫu nhiên của Redlock cũng không xác định được thứ tự. Vì vậy, chỉ có bộ đếm chưa đủ để giải quyết vấn đề fencing ở đây. Với những hạn chế này, cách dùng Redis như trên không phù hợp khi tính đúng đắn phụ thuộc vào cơ chế fencing đáng tin cậy qua các sự cố.
Dù vậy, nhiều ứng dụng vẫn chấp nhận được race condition thỉnh thoảng xảy ra, hoặc có biện pháp bảo vệ khác như thao tác idempotent và ràng buộc ở database. Với những ứng dụng đó, Redis lock, dù dùng một instance hay Redlock, vẫn là lựa chọn thực tế và có hiệu năng tốt.
Các giải pháp thay thế⌗
Nếu distributed lock cần đảm bảo strong consistency, bạn có thể cân nhắc:
etcd: Có sẵn API cho lock dựa trên lease. Muốn bảo vệ các thao tác ghi vào hệ thống lưu trữ bên ngoài bằng fencing, tài nguyên được bảo vệ vẫn phải kiểm tra fencing token. etcd được xây dựng trên Raft, một thuật toán đồng thuận có chứng minh hình thức về tính đúng đắn, và đảm bảo các thao tác linearizable trên toàn cluster.
ZooKeeper: Cung cấp các cách xây dựng distributed lock bằng ephemeral sequential node.
zxid(ZooKeeper Transaction ID) là bộ đếm tăng đơn điệu với thứ tự toàn cục, có thể dùng làm fencing token. ZooKeeper dùng giao thức ZAB (ZooKeeper Atomic Broadcast) để đạt đồng thuận.
Cả hai đều là hệ thống CP (Consistency + Partition tolerance) theo CAP. Khi xảy ra network partition, chúng hy sinh tính sẵn sàng để giữ strong consistency. Sự đánh đổi ở đây là Redis cung cấp tốc độ và tính sẵn sàng, còn etcd và ZooKeeper cung cấp đảm bảo về tính đúng đắn.
Tham khảo⌗
- Redis - Mô hình replication của Redis
- How to do distributed locking - Martin Kleppmann phê bình Redlock
- Is Redlock Safe? - antirez (tác giả Redis) phản biện về việc dùng Redlock
- etcd - Concurrency API của etcd
- ZooKeeper - ZooKeeper Locks Recipe
- Raft - Thuật toán consensus Raft